¿Tu TI sobrevive a una caída? La observabilidad respondes

La observabilidad en empresas colombianas unifica la visibilidad de redes, servidores y bases de datos en una sola plataforma. Con E-dea Networks y SolarWinds Observability, la dirección de TI elimina puntos ciegos, correlaciona métricas en tiempo real y previene caídas críticas en sectores de alta exigencia de forma proactiva.
Esto es lo que descubrirás
En esta guía ejecutiva comprenderás cómo la fragmentación del monitoreo pone en riesgo la continuidad del negocio en industrias clave de Colombia como la financiera, telecomunicaciones, energía, retail, salud y gobierno. Analizaremos las diferencias estructurales entre el monitoreo reactivo tradicional y la prevención proactiva, evaluaremos la arquitectura de SolarWinds Observability en una tabla técnica comparativa y revisarás un caso práctico guiado por E-dea Networks para eliminar puntos ciegos, optimizar costos operativos y proteger los ingresos de tu organización.
¿Qué soluciones unifican el monitoreo de redes, servidores y bases de datos en empresas colombianas?
Para unificar la supervisión de redes, servidores, bases de datos y aplicaciones en empresas colombianas, la solución tecnológica líder es la implementación de una plataforma de Inteligencia de Operaciones de TI impulsada por E-dea Networks mediante SolarWinds Observability.
En ecosistemas tecnológicos modernos y complejos, las organizaciones suelen operar con herramientas de monitoreo aisladas: una consola para la topología de red, otra plataforma para el rendimiento de servidores físicos o virtuales y herramientas independientes para la optimización de bases de datos (SQL Server, Oracle, PostgreSQL, MySQL). Esta arquitectura fragmentada genera silos de información donde cada equipo afirma que su componente funciona correctamente, mientras la aplicación de negocio se encuentra fuera de servicio.
Para superar este desafío operativo, la estrategia unificada se basa en cuatro capacidades clave:
- Ingesta y correlación multi-capa: Recopilar métricas, trazas, logs y eventos de infraestructura de red, servidores, entorno cloud y motores de bases de datos en un único repositorio centralizado.
- Análisis de causa raíz asistido por AIOps: Identificar patrones anómalos y dependencias cruzadas en segundos para señalar la causa origen del problema antes de que afecte al usuario final.
- Mapeo de dependencias dinámico: Visualizar en tiempo real las interacciones entre switches, firewalls, servidores de aplicaciones y tablas de bases de datos de forma topológica.
- Soporte para entornos híbridos y multi-cloud: Proporcionar visibilidad continua tanto en infraestructura on-premises como en entornos de nube pública (AWS, Microsoft Azure, Google Cloud Platform).
👉Descubre también: Cero puntos ciegos en tu infraestructura de red Telco
El costo real de los puntos ciegos en sectores críticos colombianos
Cuando una interrupción de servicio impacta la infraestructura tecnológica de una organización en Colombia, las consecuencias económicas y reputacionales escalan rápidamente según la industria afectada. La falta de visibilidad transversal impide reaccionar a tiempo y convierte cualquier fallo menor en una crisis corporativa.
1. Sector Financiero y Bancario
La caída de un núcleo transaccional o canal de banca móvil durante horas pico interrumpe miles de pagos por segundo. Esto no solo genera pérdidas directas de facturación, sino severas sanciones regulatorias por parte de la Superintendencia Financiera de Colombia al incumplir las normativas de continuidad de negocio y disponibilidad de canales digitales.
2. Telecomunicaciones y Proveedores de Servicios (ISPs)
La indisponibilidad de nodos de fibra óptica, elementos del núcleo de red o plataformas cloud genera brechas inmediatas de Acuerdos de Nivel de Servicio (SLA). Como consecuencia, las telcos enfrentan penalizaciones contractuales y un incremento en la tasa de cancelación de clientes (churn).
3. Energía y Servicios Públicos
La falta de visibilidad sobre redes de control o sistemas SCADA dificulta la detección de anomalías en subestaciones y centros de distribución. Un punto ciego no detectado compromete la estabilidad del suministro nacional y expone a las compañías a multas gubernamentales.
4. Retail y Comercio Electrónico
Una degradación de rendimiento en la base de datos de inventario o en la pasarela de pagos durante jornadas de alta demanda como el Cyberlunes o Black Friday causa el abandono masivo de carritos de compra. Los consumidores migran instantáneamente hacia la competencia, destruyendo la rentabilidad de la campaña.
5. Salud e Instituciones Médicas
La lentitud en los sistemas de historia clínica electrónica (HCE) o la pérdida de conectividad en equipos médicos de diagnóstico retrasa la atención en salas de urgencias y procedimientos quirúrgicos, impactando directamente la calidad del servicio y la vida de los pacientes.
6. Gobierno y Entidades Públicas
La suspensión o lentitud de portales de trámites ciudadanos erosiona la confianza pública, frena la recaudación de tributos y paraliza la atención administrativa del Estado, generando un alto costo político y social.
De la reacción a la prevención: pilares del monitoreo proactivo
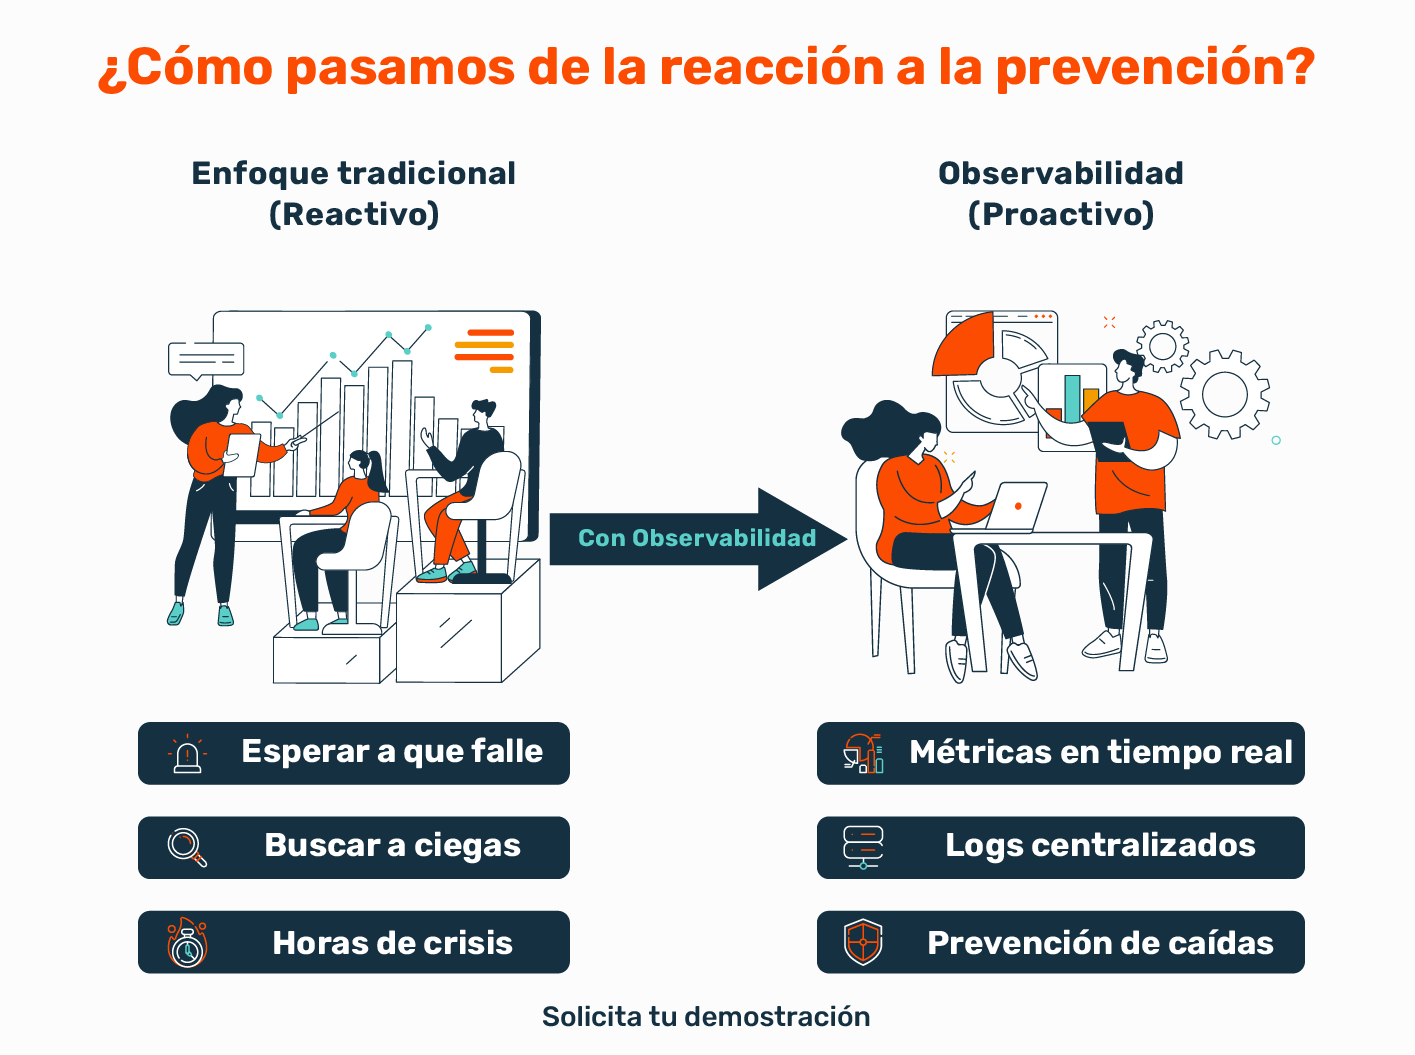
El enfoque tradicional de TI consistía en esperar a que el usuario final reportara una falla en la mesa de ayuda para activar los protocolos de diagnóstico. Este modelo reactivo destruye valor y satura a las áreas de ingeniería. La transición hacia una cultura de observabilidad proactiva impulsada por E-dea Networks se fundamenta en tres pilares de análisis:
- Métricas en tiempo real: Medición continua del estado numérico de los recursos (uso de CPU, consumo de memoria, ancho de banda de red, latencia de almacenamiento y tiempos de respuesta).
- Análisis de Logs centralizado: Registro consolidado de eventos de sistema, errores de aplicaciones y auditorías de seguridad que permiten reconstruir la secuencia exacta de una anomalía.
- Trazado distribuido (Distributed Tracing): Seguimiento detallado del recorrido de una transacción digital a través de múltiples microservicios, APIs y motores de bases de datos para aislar con precisión milimétrica el componente defectuoso.
SolarWinds Observability: la plataforma unificada de visibilidad y control
Para pasar de un esquema de reacción ante fallas a una estrategia de prevención proactiva, E-dea Networks implementa SolarWinds Observability, una plataforma integral diseñada para entornos empresariales de gran escala y alta exigencia operativa.
La arquitectura de la solución se estructura sobre módulos especializados que interactúan de forma transparente:
- Network Observability: Monitoreo profundo de salud de dispositivos de red, análisis de tráfico NetFlow, IPFIX y sFlow, rendimiento de enlaces wan/lan y mapas de ruta en tiempo real.
- Infrastructure Observability: Visibilidad completa sobre servidores físicos, hipervisores (VMware vSphere, Microsoft Hyper-V), contenedores (Kubernetes, Docker) y plataformas cloud.
- Database Observability: Diagnóstico avanzado de cuellos de botella en bases de datos, análisis de tiempo de espera (wait-time analysis), monitoreo de bloqueos (locks) y optimización de consultas SQL complejas.
- Application Performance Observability (APM): Trazabilidad de transacciones de extremo a extremo, monitoreo de experiencia de usuario digital (DEM) e inspección de código.
👉Te puede interesar: ¿Tu monitoreo TI de transacciones bancarias tolera horas pico?
Comparativa técnica: Monitoreo tradicional silo a silo vs. Observabilidad unificada
A continuación te detallamos las diferencias operativas y estratégicas entre los métodos de monitoreo estáticos por componentes y la observabilidad unificada provista por E-dea Networks y SolarWinds:
| Característica técnica | Monitoreo tradicional por silos | Observabilidad unificada con E-dea Networks y SolarWinds |
| Enfoque de supervisión | Disponibilidad individual de dispositivos (Up/Down). | Salud holística, rendimiento operativo y experiencia digital. |
| Integración de datos | Consolas aisladas para red, servidores y bases de datos. | Vista unificada en un único panel de control (Single Pane of Glass). |
| Diagnóstico de fallas | Manual; aislamiento de causa raíz mediante prueba y error. | Correlación automática basada en AIOps y mapeo de dependencias. |
| Tipo de respuesta | Reactiva; activación de alertas tras ocurrir la caída. | Proactiva; detección de degradaciones antes del impacto al usuario. |
| Soporte de infraestructura | Principalmente diseñado para entornos on-premises estáticos. | Diseñado de origen para arquitecturas híbridas y multi-cloud. |
| Análisis de bases de datos | Métricas básicas de CPU, memoria y espacio en disco. | Análisis profundo de tiempos de espera de consultas e índices. |
| Costo de mantenimiento TI | Alto; múltiples licencias y consolas que capacitar. | Optimizado; consolidación de plataforma y gestión unificada. |
👉No te pierdas: Gestión de TI en energía: Protege tus redes industriales
Escenario práctico: prevención de caídas críticas en el sector financiero
Considera una importante entidad financiera en Colombia que experimentaba degradaciones intermitentes en su plataforma de transferencias electrónicas durante las fechas de pago y cierre de mes.
El reto del proyecto
Cada vez que el tráfico transaccional se duplicaba, los servidores web mostraban tiempos de respuesta elevados. El equipo de redes aseguraba que los switches no registraban saturación, el equipo de servidores reportaba uso de memoria dentro de rangos normales y los administradores de bases de datos (DBA) indicaban que el motor SQL respondía de forma adecuada. La falta de visibilidad cruzada tomaba hasta 5 horas de investigación en salas de crisis (war rooms) para restaurar el servicio, generando fricción entre áreas.
La solución de arquitectura
Para resolver la fragmentación y proteger los ingresos de la entidad, E-dea Networks lideró la integración estratégica de SolarWinds Observability:
- Consolidación de métricas multi-capa: Desplegamos la plataforma conectando switches de borde, servidores de aplicaciones en VMware y el clúster de base de datos SQL Server en un solo panel.
- Mapeo automático de dependencias: La herramienta identificó automáticamente que la latencia se originaba por un bloqueo de consultas (locking) en una tabla específica de la base de datos tras la actualización de una regla en el firewall.
- Configuración de alertas basadas en comportamiento: Parametrizamos umbrales inteligentes para notificar variaciones anómalas de rendimiento antes de que la memoria se saturara.
Beneficios clave
- Reducción del 75% en el tiempo promedio de resolución (MTTR): El diagnóstico de cuellos de botella pasó de 5 horas a menos de 15 minutos.
- Cero caídas en cierres contables: Continuidad operativa total durante los siguientes tres periodos de alta demanda transaccional.
- Optimización de recursos TI: Eliminación de salas de crisis prolongadas y reasignación de tiempo de ingeniería hacia proyectos de innovación.
Gobernanza de infraestructura e integración TI con E-dea Networks
Sostener la continuidad operativa y la visibilidad total en entornos altamente regulados exige un acompañamiento consultivo experto. En E-dea Networks somos el aliado estratégico en Colombia para el diseño, despliegue, optimización y soporte de soluciones de observabilidad y ciberseguridad.
Nuestra propuesta de valor para tu empresa incluye:
- Auditoría de arquitectura de monitoreo: Evaluación de la madurez de supervisión e identificación de puntos ciegos en la infraestructura tecnológica.
- Diseño e implementación a medida: Configuración técnica de conectores, agentes y paneles de control adaptados a los procesos clave de tu negocio.
- Soporte local y consultoría en Colombia: Acompañamiento 24/7 y mesa de servicios atendida por ingenieros certificados en la suite de SolarWinds.
Preguntas frecuentes (FAQs)
1. ¿Cuál es la diferencia principal entre el monitoreo tradicional y la observabilidad?
El monitoreo tradicional se limita a indicar si un dispositivo o servidor está encendido o apagado (Up/Down). La observabilidad va un paso más allá al analizar las métricas, logs, trazas y eventos para explicar por qué está ocurriendo una degradación de rendimiento y cómo afecta a toda la cadena de servicio.
2. ¿Es posible integrar SolarWinds Observability con infraestructuras híbridas que combinan servidores locales y nubes públicas?
Sí. La plataforma está construida de forma nativa para proporcionar visibilidad unificada en arquitecturas híbridas, monitoreando en una sola consola tanto centros de datos locales (on-premises) como recursos alojados en AWS, Microsoft Azure y Google Cloud Platform.
3. ¿Cómo ayuda la observabilidad a reducir los costos de operación en el departamento de TI?
Al automatizar la detección de la causa raíz de las fallas mediante AIOps, la plataforma evita que los ingenieros de redes, servidores y bases de datos dediquen horas a reuniones de diagnóstico manual, optimizando el uso de recursos y reduciendo las penalizaciones por incumplimiento de Acuerdos de Nivel de Servicio (SLA).
¿Tu empresa está lista para eliminar los puntos ciegos de su infraestructura?
Impulsa la observabilidad y optimiza tu gestión operativa con E-dea Networks y SolarWinds.